这不是一个「软件」,而是一份可以直接装进 AI 的方法论:一个 37KB 的 SKILL.md,融合了我这两年生图踩坑攒下的两套手艺——表情词典(让人物「演出来」)和写真级场景工程(从「这张照片为什么成立」开始写)。
它解决的问题是所有生图玩家都撞过的墙:提示词写得挺长,图却「塑料」——人物漂亮但没性格,场景精致但像样板间。根因是提示词只罗列了「有什么」,没交代「为什么这张照片成立」。
核心思想:九层结构公式
一个合格的生图 prompt,我会按九层来搭:
[成立点] 这张照片靠什么立住(场景/光/妆面/角度/动作,选一个主成立点)
[场景层] 前景 + 人物位置 + 背景(空间三层法)
[气质层] 主要气质 + 辅助气质(最多 1 个)
[动作层] 动作骨架(身体逻辑)+ 眼神 + 嘴部 + 一处面部肌肉 + 头部姿态
[妆造层] 服装颜色材质 + 妆容锚点 + 真实皮肤质感
[成像层] 设备/成像方式 + 光线来源与落点 + 色调 + 质感
[镜头层] 机位距离 + 拍摄角度 + 构图 + 镜头关系
[随机层] 可选变量(距离/动作/前景遮挡/是否看镜头)
[护栏层] 负面约束(塑料皮肤/手指畸形/大幅扭头)日常不必填满九层——最少填成立点 + 场景三层 + 主要气质 + 2~4 个动作 + 成像方式 + 镜头关系,六格就能立住一张图。
两大方法论
表情词典:让角色「演出来」
- 九种气质词定内在状态:怪诞幽默 / 妖异俏皮 / 荒诞戏谑 / 静态疯感 / 病态甜美 / 清冷疏离 / 神圣肃穆 / 哀艳宿命 / 反常萌感——每种都配了「适合的动作」和「要避免的写法」;
- 六层面部解剖法:眼睛(注意力方向)、眉毛(情绪力度与不对称)、嘴部(最先被读到的情绪)、面部肌肉(让表情不像贴标签)、头部姿态(是挑衅、脆弱还是疏离)、镜头关系(观众和人物的关系)——一层一层的肌肉记忆,而不是「微笑」「忧伤」这种空词。
写真级场景工程:从「成立点」开始写
- 成立点思维:先回答「这张照片靠什么立住」,再谈别的;
- 空间三层法:前景 + 人物 + 背景,场景密度就是这么来的;
- 成像方式写设备不写风格(「85mm f/1.4 逆光」比「高级感」有用一百倍);
- 光线写成现场:「窗格影子落在锁骨上」而不是「柔和的光」;
- 动作骨架:身体逻辑而不是死姿势——并避开「回头看镜头/扭腰回眸」这类 AI 一画就崩的雷区动作;
- 框内随机:锁住骨架,放开呼吸——同一个 prompt 出 8 张,每张都活着;
- 元素互相认识:不要把 prompt 写成购物清单,元素之间要有视线、光照、空间的交接。
两种使用模式
模式 A · 正向构造:你给一句模糊需求(「帮我写一个古风少女」),按公式逐层展开,输出中英双语(英文版优先喂 GPT Image 2,它对英文肌肉级描述理解更准)。
模式 B · 反向优化:你贴一个已有的 prompt,先过十二项诊断清单(摄影词堆砌/气质词打架/动作死摆/元素不交接/成立点缺失……),再按六种策略重构(加骨骼 / 拆气质词 / 精简摄影词 / 统一逻辑 / 找成立点 / 动作改骨架)。
SKILL 里还带了 5 个实战案例:古风少女·慵懒疏离、民国旗袍·清冷名伶、民国名伶·哀艳宿命(反推优化)、场景驱动写真·白兰柔雾、场景+表情双引擎·旧阁书案×反常萌感——每个都是「原始需求 → 优化过程 → 最终 prompt」的完整迭代记录。
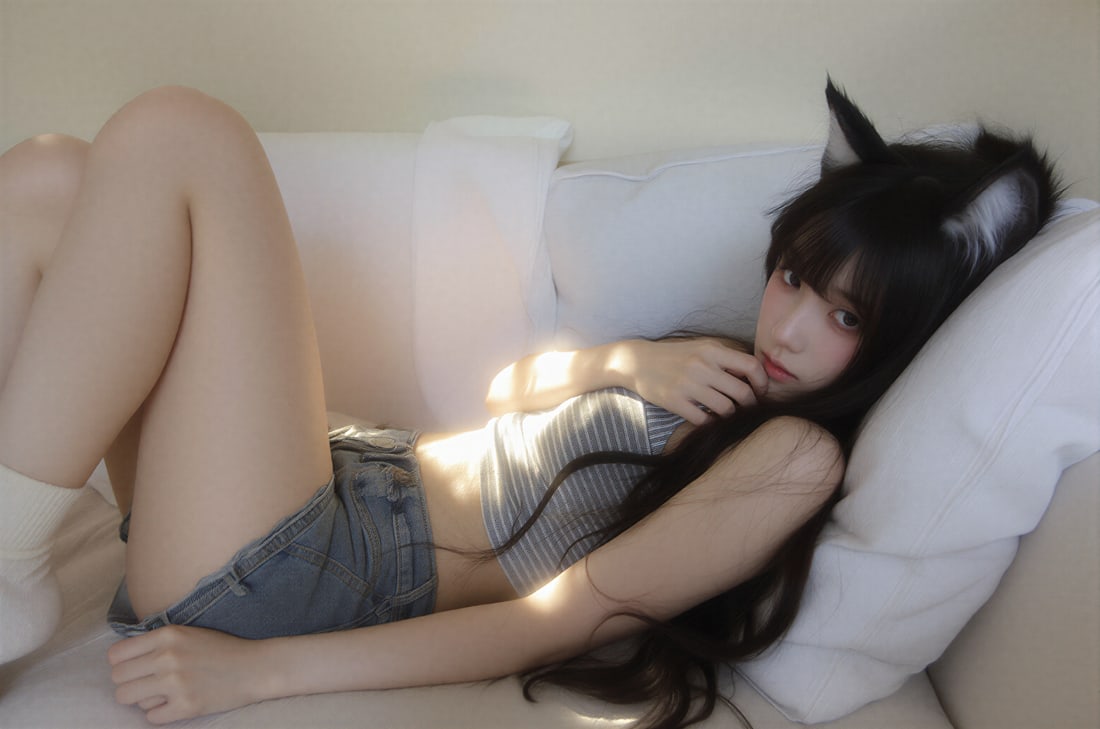
出图效果
官方仓库的样图(ComfyUI 出图,按方法论构造的提示词):
怎么装、怎么用
- 到仓库下载 SKILL.md;
- 放进你的 Agent 的 skills 目录(如
~/.dsh/skills/image2-prompt-optimizer/,或 Claude Code / 任何支持 SKILL.md 规范的 Agent); - 触发词:优化生图提示词 / 生图提示词 / 表情词典 / 反推提示词 / 写真 prompt——然后丢需求或丢旧 prompt 给它就行。
我的生图工作流就是:需求 → 这个 skill 优化出中英双语 prompt → 英文版喂 gpt-image-2(或 ComfyUI)→ 不满意就把成图问题反喂回去做反向优化。
链接
- GitHub 仓库:beiyege-01/image2-prompt-optimizer
- 方法论本体:SKILL.md(776 行,自包含,离线可用)