站里已经有两条数字人的技术路线:一条把 ASR / TTS / 渲染全搬本地(DSH 语音 AI 女友),一条全塞进云端只留一个悬浮窗(云端数字人分享版)。这个项目是第三条——组件化:只把最难最贵的那一件事(渲染 + 推流)交给 Vidu,其余全部留在你自己的机器上。
一句话概括成本结构:Vidu 按秒收渲染费(1 积分/秒),LLM、TTS、弹幕、歌单、动作编排、统计,一分钱不花,因为都跑在本机。
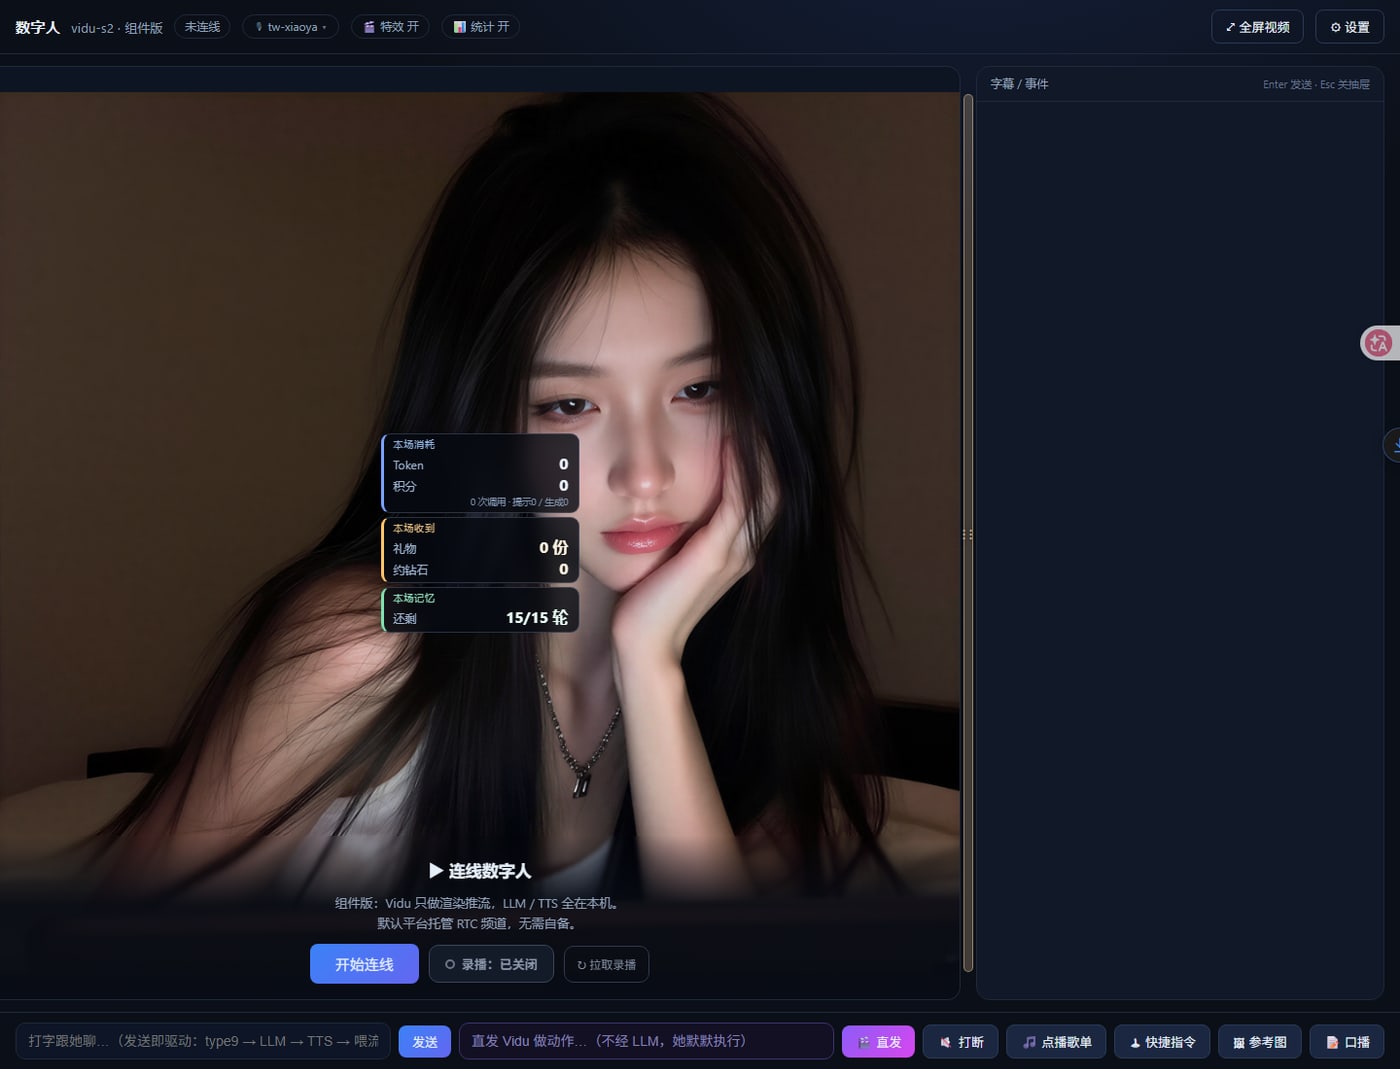
这是本机实拍(未连线状态):左上角是当前人设与音色,画面中央浮着本场统计——Token、积分、礼物钻石、记忆剩余轮数,能拖到任意位置。
为什么做成「组件版」
前两条路线的取舍都很极端:
- 全本地:模型、容器、显卡全自己扛,自由度最高,但装一次要一整天,显存还要和别的程序抢;
- 全云端:开箱即用,但音色、人设、歌单、动作全在别人的服务里,改一点都要看接口脸色。
组件版把边界划在「渲染」这一层:Vidu 只接收三样东西——文字、PCM 音频、动作指令,然后吐回一路实时视频流(WebRTC/ARTC)。剩下的链路自己组装:
| 段 | 具体做什么 |
|---|---|
| 输入 · 舞台页(浏览器) | 打字聊天、直发动作、点歌、点快捷指令 |
大脑 · 本地桥 :8795 | LLM 流式 → 按标点分句 → 本机 TTS → PCM 直推 |
| 渲染 · Vidu 云端 | 收 type9 动作与 PCM,渲染口型/表情/动作,回 WebRTC 视频 |
| 观看 · 舞台页 | 订阅 RTC 画面,叠加字幕、动作特效与本场统计 |
好处是每个环节都能替换、能观测、能改:换音色只是换一个目录,换人设只是改一段提示词,弹幕怎么念、动作怎么触发,全在本地代码里。
它由哪些部分组成
| 部分 | 位置 | 做了什么 |
|---|---|---|
| 舞台页 | stage/index.html | 单文件、无构建、无框架,约 210KB;画面、字幕、快捷指令、点播、参考图、设置都在这一页 |
| 本地桥 | src/main.py → bridge.py | FastAPI,约 60 个接口:会话、说话、动作、点播、弹幕、人设、音色、统计、录播 |
| 引擎 | src/engine.py | 会话生命周期、喂流权、打断、动作优先级、弹幕队列、空闲搭话 |
| 路由 | src/dm_router.py | 弹幕 → 指令(别名、黑名单、静默阈值、确认条) |
| 云端 | src/vidu/ | 信令 WS、type9 动作、type10 字幕、RTC 令牌 |
| TTS | src/tts/omnivoice.py | 克隆音色、直播中热切、PCM 直出 |
攻克了哪些技术
① 一条「不断句」的语音流水线
最初的实现是喂完一句才合成下一句——听感上就是「句子中间一顿一顿」。改法是把合成和推流拆成两条并行的流水线:当前句在推 PCM 的同时,下一句已经在 TTS 里合成;LLM 那边则是流式吐字、按标点切句。
配套的还有「抢话」:打字聊天、弹幕回复、贵宾欢迎、点播,全都想说话,所以引擎里有一条硬约束——任意时刻最多只有一个「喂流者」。打断不是把队列清空就完事,得同时停掉 PCM 推流、撤销正在合成的句子、把字幕标回「已打断」。
② Vidu 信令的三条实测铁律
这部分几乎全是从事故里学来的,代码里就写着:
- 成功不回执。发完
type9,服务端不会回 ack,几秒内画面自己变;失败才回type=14。所以「没回包」不等于「没执行」。 - 不要去重、更不要重发。它本身不做幂等,你重发一次,她就做两遍动作。
- 单块发送必须带超时。WS 背压时
send()能永久挂住(实测卡过 25 秒),一个 await 就能冻住整条语音链。
还有一个反直觉的:纯 TTS 期间服务端可能 252 秒不回任何包。所以看门狗不能只看「有没有收到消息」,否则会把正常的长时间朗读误判成卡死。
③ 动作优先级:贵宾 > 手点 > 编排 > 弹幕
观众刷一个 99 钻以上的礼物,她应该立刻拿出礼物贴脸展示,而不是排队等前面的编排播完。于是动作走一个优先级队列:
| 优先级 | 来源 | 行为 |
|---|---|---|
| 最高 | 单笔 > 99 钻的贵宾 | 插队执行,本场获得最高动作权 |
| 高 | 主播手点 / 直发 | 立即执行 |
| 中 | 固定编排(组内 2 秒、组间 15 秒随机轮播) | 到点执行,可被上面两类打断 |
| 低 | 弹幕触发的动作 | 排队,不再被编排挤掉 |
弹幕从「被编排挤掉」改成「排队」,是因为实测观众会连续刷同一条指令,丢掉就等于没回应。反过来,手点动作连着点会把 Vidu 的动作队列塞满、卡在同一个动作上,所以动作之间要留 gap,必要时清队列。
④ 弹幕不该直接喂给大模型
如果每一条弹幕都丢给 LLM,它就会自由发挥:观众说「转个圈」,她可能回一句「好的呀」然后什么都不做。所以中间加了一层 dm_router:先做别名匹配(「转圈 / 转个圈 / 转一圈」→ 同一个指令)、黑名单、静默阈值,命中动作就直接发 type9,没命中才走聊天。
需要确认的动作会进「确认条」,主播点一下才执行——直播场景里,误执行比不执行更贵。
⑤ 点播、歌词与「让位」
放歌时最怕两件事:歌词对不上、说话打断歌。这里的做法是:
- 歌词不再推给 Vidu 渲染(实测不可靠),改在本机对齐、由舞台页显示;
- 说话会「让位」——歌中进来的弹幕先排队,歌完自动回到聊天;
- 曾经「放歌开始断断续续」,根因是每条弹幕都触发一遍完整链路(LLM + TTS + 推流),把音频流挤爆了;改成按批合并、按优先级调度之后才稳。
⑥ 观测与自愈
直播是要连续跑几小时的,所以「出问题能查」比「不出问题」更重要:
- 所有日志落盘(桥、舞台、托盘各一份),事故现场保留完整堆栈;
- 看门狗盯着喂流权、TTS、WS 心跳,异常时重建而不是整个进程崩掉;
- 断线自动重连,重连后把当前人设、音色、动作库重新对齐;
- 录播由服务端录、播完自动下载;Vidu 侧封盘要几分钟到几十分钟,所以页面留了「↻ 拉取录播」手动重试。
舞台页能干什么
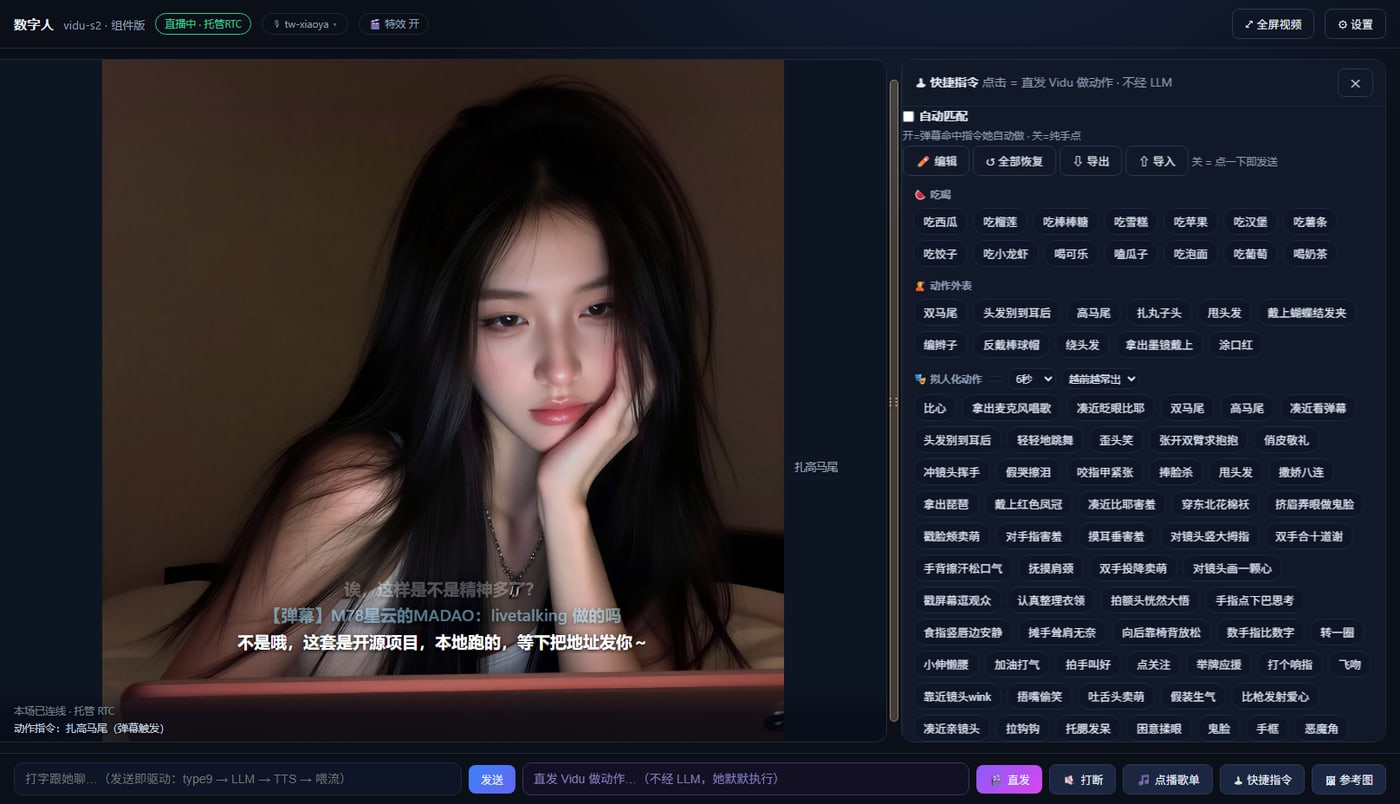
| 区域 | 功能 |
|---|---|
| 中间 | 数字人画面 + 实时字幕 + 动作指令特效(只显示从弹幕里抓出来的指令) |
| 底部输入框 | 打字跟她聊:LLM → TTS → 说话 |
| 🎬 直发 | 直接把动作指令发给 Vidu,不经过 LLM(她默默执行) |
| 🕹 快捷指令 | 点一下即发送;编辑模式可拖拽排序、改名、新建、跨组移动、导入导出 |
| 🎵 点播歌单 | 放歌(带歌词字幕),歌中自动让位 |
| 🖼 参考图 | 换装 / 拿起商品 / 换背景 |
| ⏺ 自动录播 | 让 Vidu 服务端录下这一场,播完自动下载到本地 |
| 📊 统计 | Token 用量 / Vidu 积分 / 礼物钻石 / 记忆剩余轮数,可拖动、双击复位 |
| ⚙ 设置 | 音色、开场白、字幕位置、黑名单词表 |
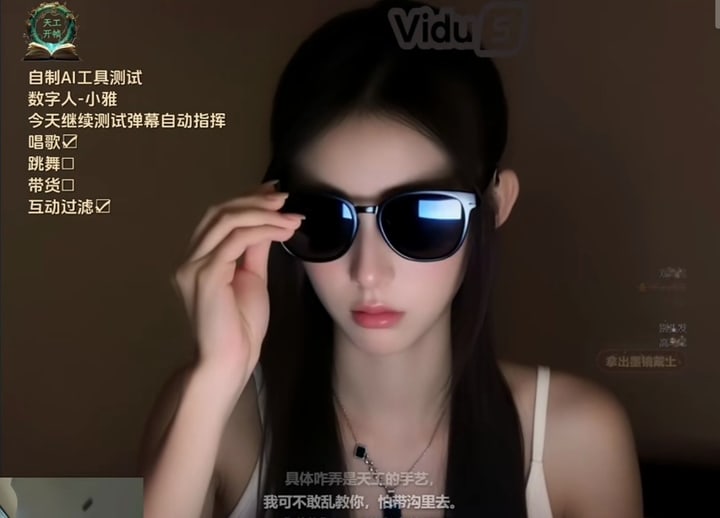
下面这张是手机端抖音直播的实拍:弹幕进来 → 舞台页把指令翻译成动作 → 数字人执行(画面里是「拿出墨镜戴上」)。
怎么用
1. 你需要的四样东西
| 项目 | 说明 |
|---|---|
| Vidu 账号 + API Key | 数字人渲染与推流,按秒计费(1 积分/秒,余额 <45 积分开不了场) |
| 一个形象(avatar_id) | 在 Vidu 控制台上传正脸照或视频,记下 ID |
| LLM API Key | 默认 DeepSeek(deepseek-flash),任何 OpenAI 兼容端点都行 |
| TTS | 目前只实现 OmniVoice(WSL2 + CUDA,支持克隆与热切);没有也能连,只是不出声 |
2. 配置
copy config.example.json config.json
# 填 vidu.api_key / avatar.avatar_id / llm.key_file / tts.voices_dir
config.json 里全是密钥,.gitignore 已经排掉了,别提交。
3. 启动
.venv\Scripts\python.exe -m src.main     # 只起桥 + 舞台页
# 或双击 启动-组件版全链路.cmd(桥 + TTS + 弹幕 + 打开舞台页,缺的组件自动跳过)
浏览器打开 http://127.0.0.1:8795/stage,点「开始连线」,等 5–15 秒画面出来。
⚠️ 连线即开始计费。测完记得点「断开」。
仓库里故意没有什么
为了避免「下载完发现跑不起来」,作者把边界写得很清楚:代码是完整的,缺的都是你自己的内容。
- ❌ 人物形象、克隆音色、人设提示词、动作库内容;
- ❌ 歌单音频(版权也不允许);
- ❌ 任何 API Key、Cookie、账号凭据;
- ❌ OmniVoice 模型权重与依赖环境。
常见问题
Q:连不上 Vidu / 401? 先看 key,再看余额——余额不足会直接开不了场,而不是报权限错误。
Q:她没有声音?
九成是 TTS 没起来。curl http://127.0.0.1:9877/ 返回 200 才算活着;WSL2 重启后 IP 会变,tts.omnivoice_base 要跟着改。
Q:画面卡、说话延迟大?
先看 GPU 占用:TTS 和渲染会抢显存,把 OmniVoice 的 --graph-buckets 调小一点通常有效。
Q:能换别的 TTS 吗?
目前 tts.engine 只实现了 omnivoice;接 Edge-TTS / GPT-SoVITS 需要在 src/tts/ 下加一个适配类。
Q:能不能不开播、只本地玩? 可以。舞台页就是本机网页,Vidu 只负责出画面,你不推流给任何平台也能对话。
配套与相关
- 弹幕采集(抖音 / B站 / YouTube / 视频号)在另一个仓库:赛博小雅 · 弹幕采集器
- 想尝鲜没验证过的新功能:试验版仓库 vidu-dh-s2-share(功能会周期性合并回正式版)
- 项目:cyber-xiaoya/cyber-xiaoya-live · 代码 AGPL-3.0,素材与品牌不在授权范围内
本项目代码永久免费,没有官方群、不卖课、不卖安装服务;看到有人卖可以直接举报。