这个项目始于一句开场白:“你好呀,我是小雅。从今往后,DeepSeek Harness 不只是你的编程搭子——它开口说话了。”
DeepSeek Harness(DSH)本来是一个编程智能体的命令行/网页壳子。我给它装上了耳朵、嗓子、脾气和一张会动的脸:点一下麦克风,她听你说话、跟你拌嘴、把回答一字一句念给你听;你出门了,她的回复自动推到你的 QQ 上;旁边那个窗口里的姑娘也不是摆设——她闲着会发呆,说话时会开口,长回复还会被实时做成口播视频。
目前在 GitHub 上是这个系列里最受欢迎的项目(882 ★,Apache-2.0)。
她有哪些本事
- ⚡ 嘴快:你说完话,她 0.5 秒内开口——FunASR 中文识别只要 150ms,TTS 几乎秒开
- 🎧 耳朵挑:-35dB 噪声门 + silero VAD 双重把关——风扇、键盘、电视声统统进不来
- 🔇 懂打断:你插嘴她就闭嘴听你说;想让她把话说完,点一下开关切回排队模式
- 🔊 声音是你的:OmniVoice 声音克隆,音色由你给的参考音频决定,600+ 语言
- 🎬 会演:长回复实时切成 ≤10 秒小段生成数字人口播视频,边生成边播,口型同步
- 📱 粘人:回复自动推到 QQ(文本 + 语音 + 图片)
- 🎛️ 随你调配:音色 / 数字人形象 / 待机动画三类独立热切换,插话/排队、数字人开关、QQ 推送全部工具行一键切
整体架构三层:浏览器里的 DSH 插件(UI、录音、播放、数字人窗口)→ 本机 Python 桥接(:8765,语音引擎编排)→ 各路引擎(FunASR / OmniVoice / DUIX 容器 / NapCatQQ)。
攻克了哪些技术
这个项目迭代了两个多月,真正的难点都不在「能不能通」,而在「好不好住」。挑六个说:
① 说话即打断,且不被环境音误伤。打断是语音助手最容易翻车的地方:风扇声、键盘声都会触发「打断」。最终方案是 -35dB 噪声门 + silero VAD 双重把关,只有真实人声才切断朗读——插话/排队两种模式工具行一键切换。
② 数字人视频从 16-20 秒压到 9-11.5 秒/段(约 -40%)。根因挖了很久:容器里 onnxruntime 因 LD_LIBRARY_PATH 缺失静默回退 CPU。修复分三步:注入 NVIDIA pip 包的 lib 目录让 CUDAExecutionProvider 生效 → 装 TensorRT 10.9 加速 onnx 子模型(Blackwell 显卡 sm_120 必须 TRT≥10.9,11.2 反而不匹配;装完还要 docker commit 固化,否则容器重建丢包)→ 启动预热(空闲时先跑一遍「TTS→特征→生成」)把首段 init_wh 从 2.3-2.7s 压到 1.3-2.1s。主瓶颈 DINet 是 Cython 黑盒,Python 层 patch 不动,这是实测出来的理论下限。
③ 分段流水线,让长回复「说个不停」。数字人单段视频超过 10 秒质量就崩。方案:按标点硬切 ≤48 字/段,段 N 播放时预合成段 N+1,状态接口带播放列表,前端一段播完无缝接下一段;语音与口型由最终视频内嵌音轨天然同步。中途打断/新轮次会作废在途任务。
④ QQ 推送的「降噪边界」。最初的版本把工具调用过程也推给 QQ,全是噪音。最终规则:每回合只推首段+末段,末段 4 秒静默 debounce 确认——中间的过渡文本永不推。纯聊天回合立即推一次。效果是 QQ 收到的全是实质回答。
⑤ 数字人开关下沉到桥接。前端开关只是「不提交任务」,桥接照样空转预热、对着容器疯狂重试——显存也一直被占。改法:开关变成桥接的运行时状态,关闭时清队列、停在途任务、停预热、零 DUIX 流量,甚至联动 docker stop 直接放掉显存;打开时 docker start + 等就绪 + 预热。另有连续失败判死(30 秒连不上回退纯语音),不会闷头重试 15 分钟。
⑥ 可观测性。「任务到底提交了没有」曾经无从查证:现在 /api/dh/status 带计数器(受理数/真正提交段数/前端轮询数)和轮转文件日志。排查口诀:轮询在涨但提交为 0 → 前端没提交(多半是语音总闸),不是桥接的问题。
一步一步装起来
项目分两部分:浏览器插件(纯 UI)+ Python 桥接(真正的引擎编排)。插件没有桥接就是空壳,所以核心是先把桥接跑起来。
- 克隆主仓库:
git clone https://github.com/beiyege-01/dsh-voice-ai-girlfriend.git,进bridge/建 Python 3.11+ 虚拟环境,装依赖(FunASR、fastapi、uvicorn、httpx、sounddevice等); - TTS 引擎二选一:轻量用 Qwen3-TTS(仓库内置支持);要低延迟克隆音色,按仓库文档部署 OmniVoice(建议 WSL2 + FlashInfer,克隆首轮 18s → 1.6s);
- (可选)数字人:装 Docker Desktop,起 DUIX 容器(需 NVIDIA GPU);不装也能用——关掉数字人开关就是接近即时的纯语音朗读;
- (可选)QQ 推送:装 NapCatQQ,小号扫码登录,把 token 填进
bridge-config.json; - 装插件:在 DSH 里
dsh plugin add github:beiyege-01/dsh-voice-ai-girlfriend-plugin,刷新页面即生效; - 一键全栈(推荐):每天开机后先开 Docker Desktop,再双击
bridge/start-full-stack.cmd——按正确顺序拉起 WSL TTS、桥接、DSH,最后打印一张自检表,浏览器用带 token 的链接自动打开。
每天怎么用
主界面就是 DSH 的对话页,语音能力全部收在输入条的工具行里——这是本机正在运行的实拍(工具行特写):
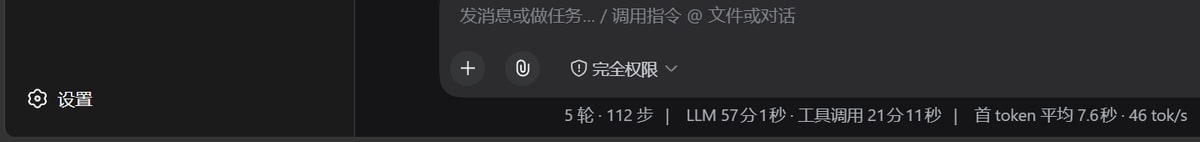
工具行从左到右:输入框、附件、完全权限下拉、语音总开关(喇叭)、麦克风(按住说话,0.5 秒接话)、数字人开关、音色/形象/待机三连切。
日常就这么几件事:
- 说话:点麦克风说完即走,她边转念边开口;插嘴就打断,想让她念完切「排队模式」;
- 换声音/换形象/换待机:🎙️👤🖼️ 三个按钮各自循环,选择存 localStorage,重启自动恢复;新增素材零代码(见下节);
- 数字人开关:开 = 回复实时生成分段口播视频,画面与 TTS 同步播;关 = 纯语音,接近即时,还顺便给 GPU 放假;
- 出门:QQ 上继续聊,文本 + 语音都推。
自定义素材(都是放文件就行)
| 想换什么 | 放哪里 | 生效方式 |
|---|---|---|
| 音色 | voices/我的声音/:放 ref_audio.wav(10 秒干净人声)+ ref_text.txt(实际朗读文本) | 重启桥接后工具行切换 |
| 待机动画 | assets/bg-images/我的组名/:放视频或图片 | 无需重启,即时切换 |
| 数字人形象 | DUIX 共享卷 temp/:放任意 mp4 | 工具行切换,输出规格跟随视频 |
常见问题
Q:刷新页面之后她没反应? 这是防历史回放的既有设计:刷新后再发一条新消息才会进入语音管道,刷新前那条不会被提交。
Q:数字人一直没动静?
先看语音总开关(喇叭)——它是整条管道的总闸,关掉时数字人也不会提交;再看桥接统计:polls 在涨但 submits=0 就是前端没提交,不是桥接的问题。
Q:显存不想被一直占着?
数字人开关关掉即可——桥接会联动 docker stop 停掉容器,零 DUIX 流量,显存立刻放掉;再打开时自动 docker start 并等就绪(冷启动 1-3 分钟)。
Q:打断了但老是误触发? 调 -35dB 噪声门与 VAD 灵敏度;风扇/电视环境复杂的房间建议关窗使用(实测有效)。
链接
- 主仓库:beiyege-01/dsh-voice-ai-girlfriend(Apache-2.0)
- 独立插件包:beiyege-01/dsh-voice-ai-girlfriend-plugin
- 效果演示:抖音 数字人口播 ① / ②——回复实时生成的分段口播视频实录
- 部署疑难:仓库 README 附完整适配矩阵(桥接 Python 3.14 / OmniVoice WSL2 / DUIX TensorRT / Docker Desktop)与 DSH 拯救手册