这个工具的起因是一句传闻:王朔自称只认识三千多个常用汉字。
我第一次听到的时候半信半疑——三千多个字真能写出那样的东西?作为一个兴趣使然的 AI 动画师,我第一时间想到的不是去找答案,而是去找方法:与其争论,不如把一部小说拖进程序里,用统计验证它。
于是就有了这台「文风蒸馏器」。它最后做的事情远超当初的验证:把任意一部小说,蒸馏成一份结构化的「文风操作系统」——字词云、常用字词覆盖率、八维行文风格,甚至是一份可以直接喂给 Claude / DSH / Cursor / 本地大模型的通用文风 SKILL,让 AI 用这本书的笔法替你写作。
它是怎么做的
整个工具是一条纯本地的单文件服务:
- 后端:Python 3.12 + FastAPI + uvicorn,起在
127.0.0.1:8899,全部分析在你机器上完成; - 前端:原生 HTML + ECharts + wordcloud2.js,离线可用,没有构建链也没有框架;
- 分词:jieba 做中文分词与词性标注;
- 语料库:内置《通用规范汉字表》8105 字、常用词表 5.6 万、成语库 3 万+、唐诗宋词名句库 5 万+;
- 方法论:融合了女娲.skill(表达 DNA)、仓颉.skill(流水线/三重验证)、wenfeng-skill(文风模板)三家所长——蒸馏出的 SKILL 不是简单的高频词罗列,而是「叙事模型 + 身份卡 + 母题系统」的结构化文风档案。
文本永不外传:统计、词云、验证全部本地计算;只有当你主动勾选 LLM 润色时,才会把统计摘要和少量采样句发给所选后端(DeepSeek / MiniMax / 本地 llama.cpp / 自定义)。
攻克了哪些技术
这个工具开发中最有意思的部分,恰好是那些「不做打包、不做中文 NLP 根本遇不到」的坑。挑六个说:
① onefile 打包的数据丢失。PyInstaller 的 onefile 模式会把程序解压到临时目录 _MEIPASS 运行,配置和历史如果写在那里,重启就全丢。最终的方案是把资源分成两类:只读资源(语料库、静态页)留在 _MEIPASS,可写数据(配置/历史/产出的 SKILL)全部落到 exe 旁边的 appdata/——重装工具时把旧 appdata 放回去,历史就都带走了。
② multiprocessing 在 exe 里自我复制。开发版里用进程池并行分析文本很正常,但打包成 exe 后,子进程 spawn 会重新运行整个 exe——点一次分析,任务管理器里的自己越变越多。最后在 __main__ 里加 freeze_support(),并在 frozen 环境下禁用并行,退化为单进程分析(几十万字 10–40 秒,可接受)。
③ 前端混淆的累积膨胀事故。为了防破解,发布前 app.js 要过 javascript-obfuscator 混淆。有一次失败的构建跳过了「恢复源码」步骤,导致混淆版被再次混淆,文件滚到 37MB。现在构建脚本用 try/finally 无条件恢复源码版,并在开头设了 300KB 大小守卫——超限直接报错,绝不许在混淆版上重混淆。
④ 诗词引用检测的误报。检测「小说里引用了多少唐诗宋词」听起来简单,做起来全是误报:模糊锚点匹配会把成语当成诗句。最终落成三层匹配——整句精确 → 半句拆分(10 字拆 5+5,14 字拆 7+7)→ 模糊锚点,并且给锚点加了排除项:成语库里的不算、禁用常见起始字、单行命中数封顶。误报率压下来之后,《秦吏》那类历史小说的诗词引用数才有参考价值。
⑤ LLM 输出污染。接入 MiniMax / DeepSeek 做润色时,推理模型的 <think>…</think> 思考块和 markdown 代码围栏经常漏进正文,甚至有英文思考混进中文分析。专门写了一个 _clean_llm_output() 剥离层,identity 任务偶发「只出思考不出正文」还会自动重试一次。
⑥ 防盗版水印。每个 exe 内置唯一编号水印,「关于」页底部的副本编号就是它——不影响的正常使用,但万一遇到倒卖,能查出是从哪一份流出的。
五分钟上手
- 到 GitHub Releases 下载
novel-insight.exe(单文件 56MB,内置 Python 运行时,免安装); - 双击运行,浏览器自动打开
http://127.0.0.1:8899(没开就手动输入); - 把小说文件拖进虚线框——支持
txt / docx / epub / mobi / md,也可以直接粘贴正文; - 等待分析(几十万字的小说约 10–40 秒),自动进入概览页;
- 用完关掉黑色命令行窗口即停止服务。
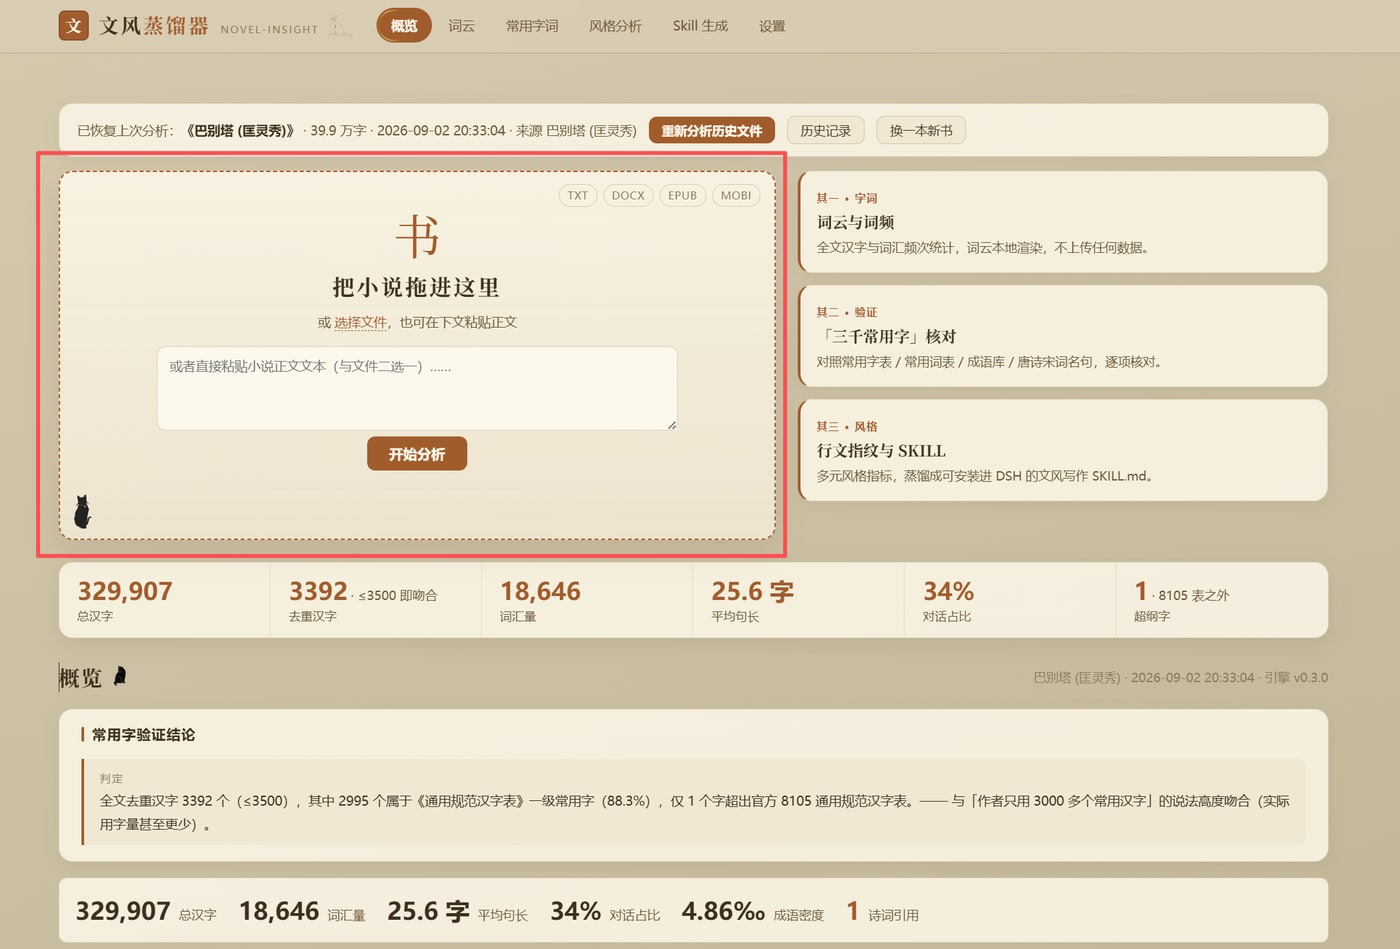
提示:exe 是 PyInstaller 单文件包,个别杀毒软件可能误报,点「更多信息 → 仍要运行」即可;介意的话 Release 附有 SHA-256 可自行校验。exe 旁边会生成
appdata/存放配置与历史,这是正常现象。
页面导览
① 概览:一页看懂这本书
六张 KPI 卡(总汉字 / 词汇量 / 平均句长 / 对话占比 / 成语密度 / 诗词引用)+ 常用字验证结论——就是那个「王朔问题」的正式回答:全书去重汉字是否落在常用字规模内。下面再配句长分布、词性分布、情感色调三张图,以及高频词 Top30、高频实字 Top20 和新词候选。
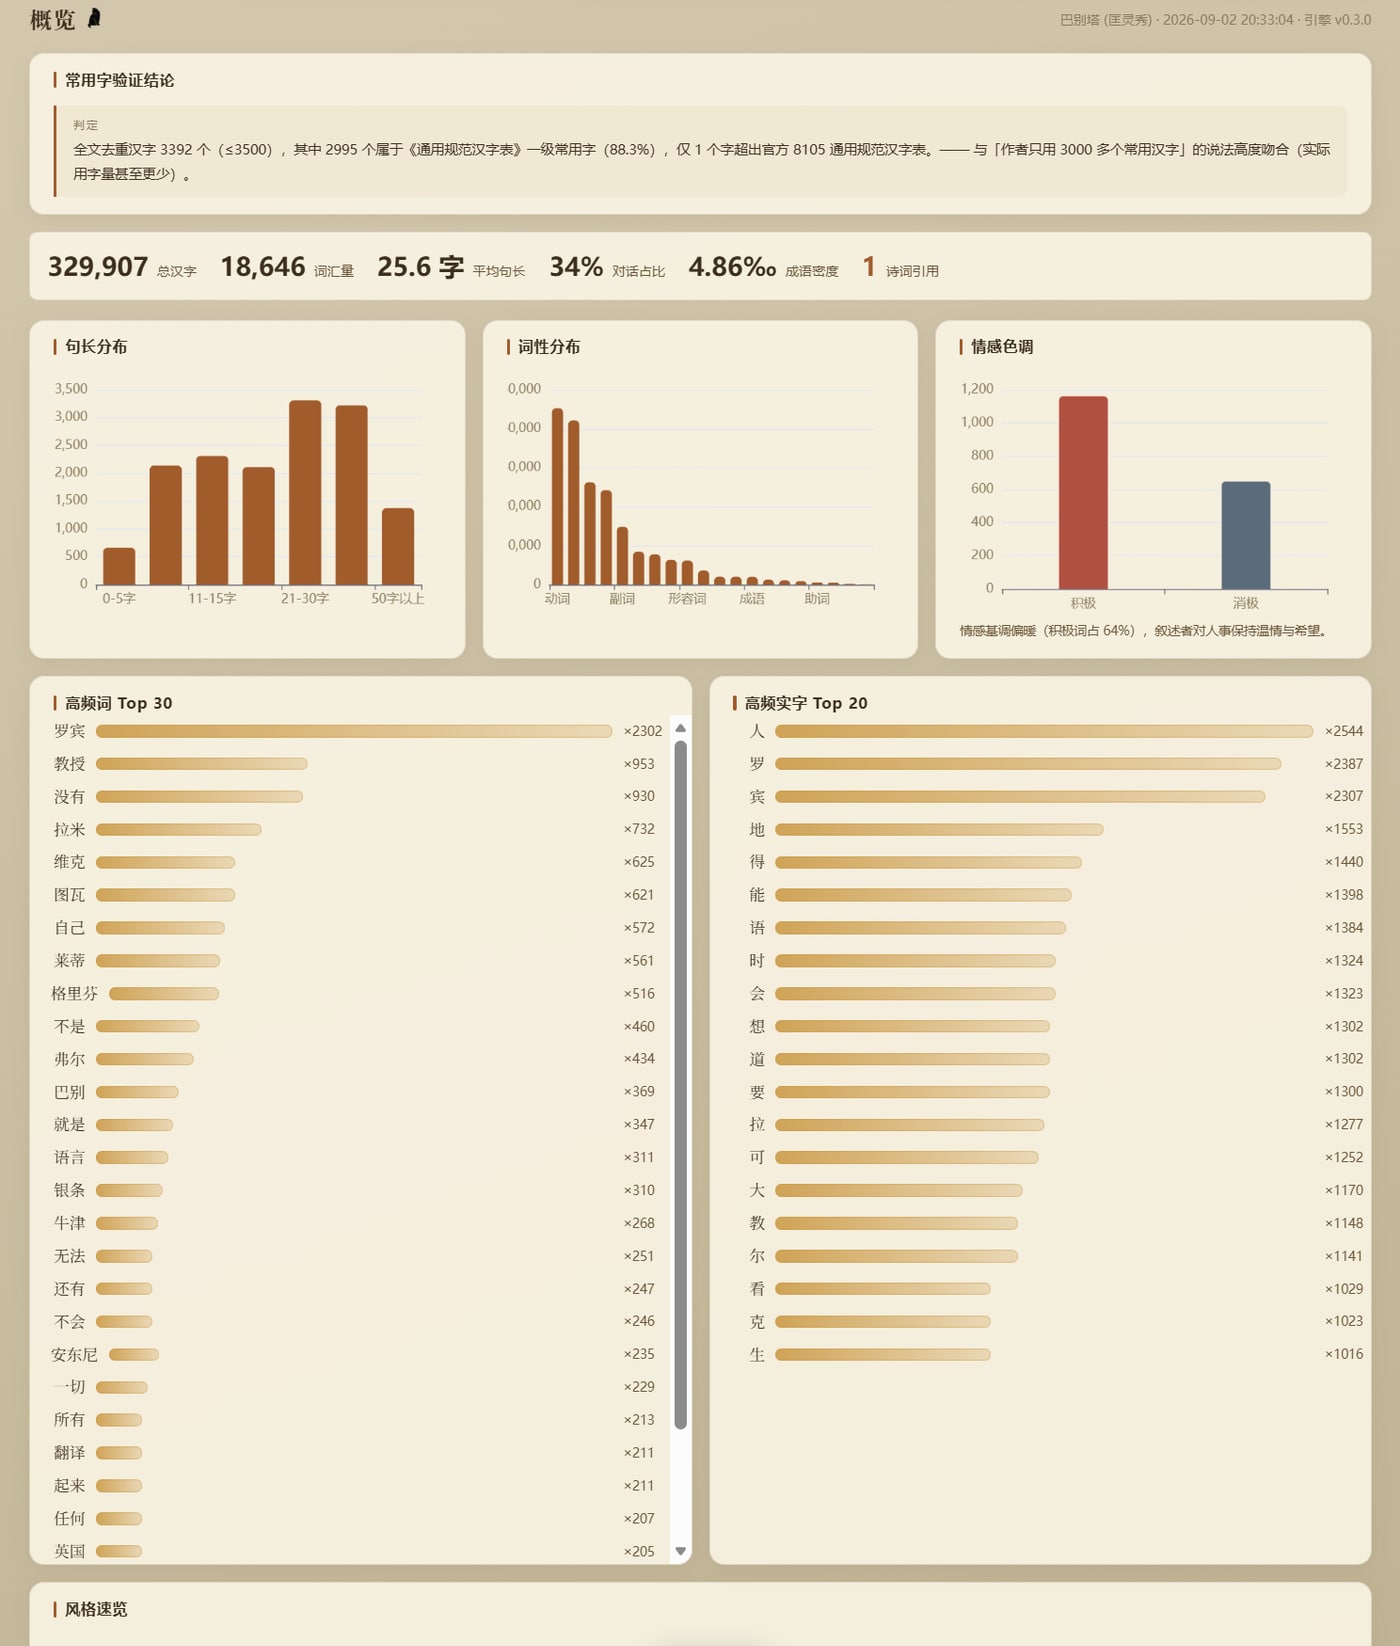
② 词云:四种云,随便玩
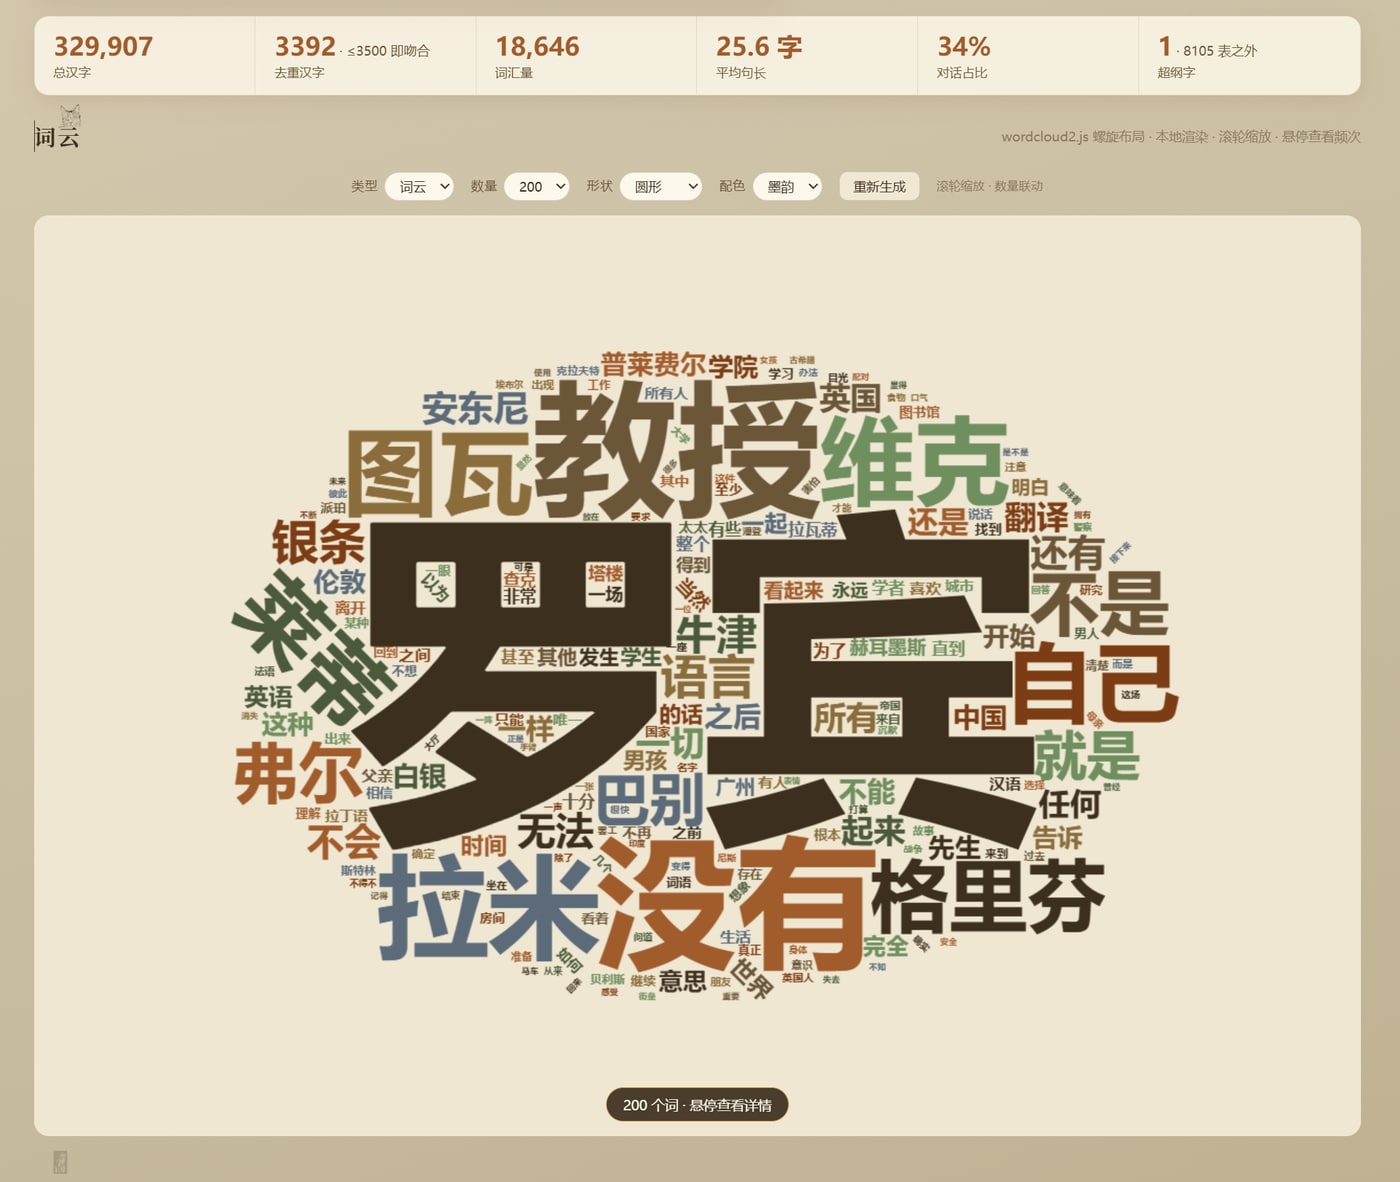
词云 / 字云 / 成语云 / 诗词云,数量 50–300,形状有圆 / 心 / 菱 / 三角 / 五角 / 星;滚轮缩放,悬停看频次,诗词云按诗句长度归一权重。
③ 常用字词:四个子页签
常用词(对照官方《现代汉语常用词表》)、成语(密度 = 每千字命中数)、诗词(三层匹配 + 原句出处)、常用字(3500 常用字 / 8105 通用规范字覆盖率 + 超纲字清单)。
④ 风格分析:八个维度
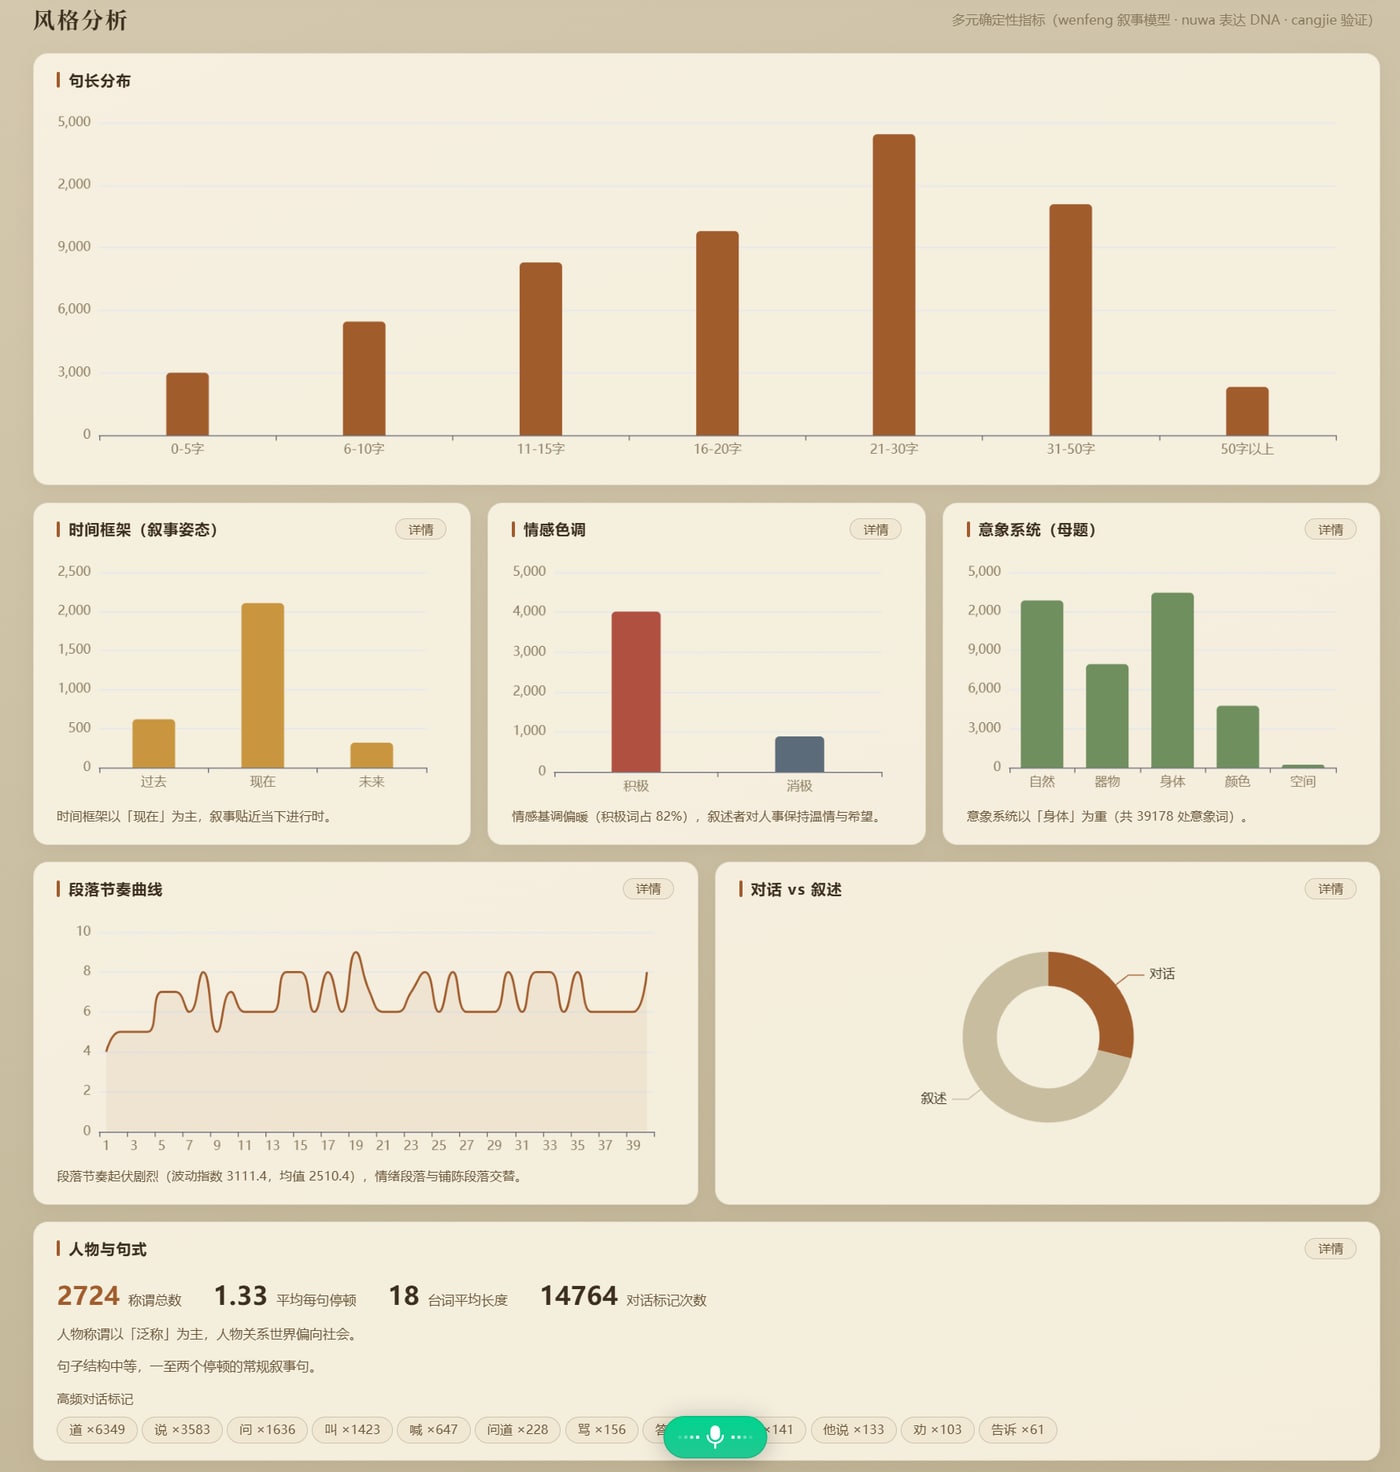
句长分布、时间框架(叙事姿态)、情感色调、意象系统(母题)、段落节奏曲线、对话 vs 叙述、人物称谓、句式复杂度——每一维都可以点「详情」看深度解读。
⑤ Skill 生成:这是整个工具的灵魂
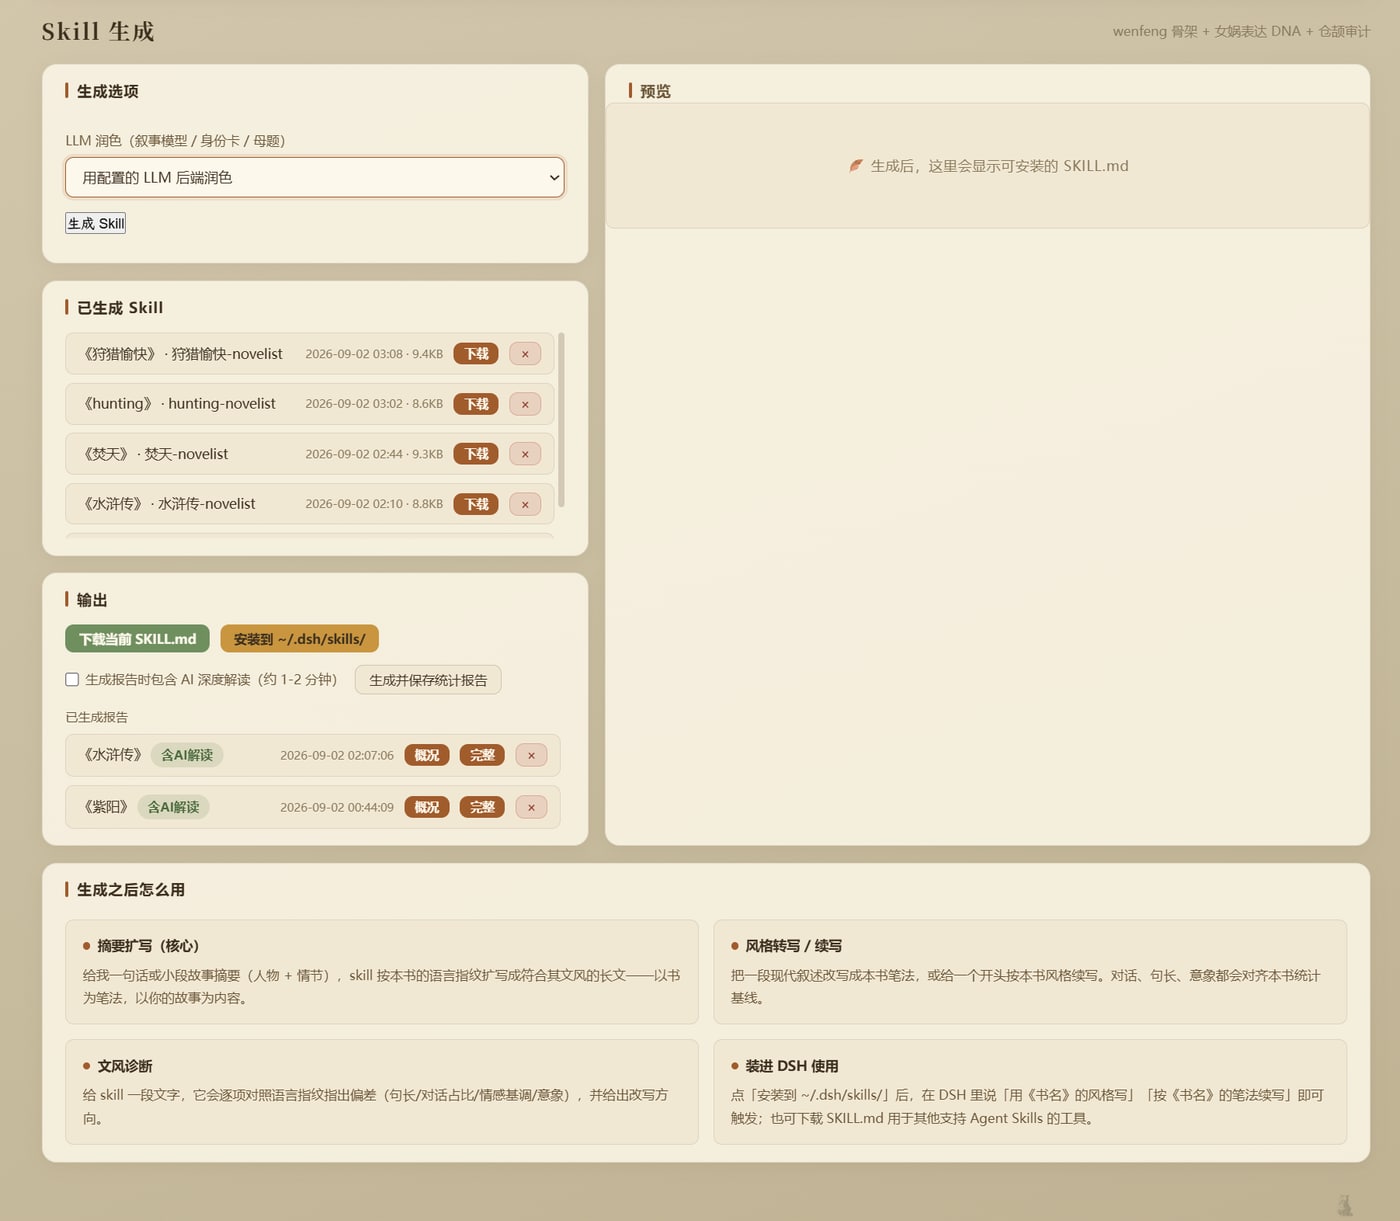
分析结果最终蒸馏成一份 SKILL.md(标准 Markdown + frontmatter)。可以选纯规则模板(离线,秒出),也可以勾选 LLM 润色让后端把叙事模型、身份卡、母题写得更文学(约 1–3 分钟)。生成后右侧深色预览框里就是成品,可以下载,也可以一键安装到 ~/.dsh/skills/。
生成后还会自动做一轮成品质检(评价页),对照各项指标确认 SKILL 没有失真:
蒸馏出的 SKILL 怎么用
SKILL 是通用格式,凡是支持「Skill / 自定义指令」的 Agent 都能吃:
| 用在哪 | 怎么放 |
|---|---|
| Claude(Claude Code / 桌面版) | 放入 skills 目录即可 |
| DSH | 工具里点「安装到 ~/.dsh/skills/」,然后直接说「用《书名》的风格写」 |
| Cursor / Windsurf 等编辑器 | 作为规则文件引用 |
| 任意 LLM 对话 | 把 SKILL.md 内容粘给模型,说明「以这份文件作为写作风格」 |
四个典型场景:摘要扩写(给一句故事梗概,按本书语言指纹扩写成长文)、风格转写/续写(把现代叙述改成这本书的笔法)、文风诊断(丢一段文字,逐项对照指纹指出偏差)、AI 仿写(让任意模型顶着一本书的腔调写新内容)。
常见问题
Q:双击 exe 后浏览器没自动开?
手动访问 http://127.0.0.1:8899。若已有一个实例在跑,再次启动只会打开浏览器指向它——这是单实例守护,防止多实例抢端口。
Q:想换端口?
先 set NOVEL_INSIGHT_PORT=8900 再运行 exe(或设系统环境变量)。
Q:分析历史和配置存在哪?
exe 旁的 appdata/(config.json + 历史 + 产出的 SKILL)。重装后把旧 appdata 放回即可保留。
Q:LLM 润色怎么配? 设置页选后端(DeepSeek 在线 / MiniMax / 本地 llama.cpp / 自定义)→ 填 Base URL、模型、Key → 测试连接。不配置也能用全部核心功能,只是 SKILL 走纯规则模板。
链接
- GitHub 仓库:beiyege-01/wenfeng-TGKZ-studio
- 下载:Releases 页面(v0.3.1 SHA256:
B5A888DC…B1EC59,见 Release 附注)
愿你也能在这个时代里,找到属于自己的那份好奇心。